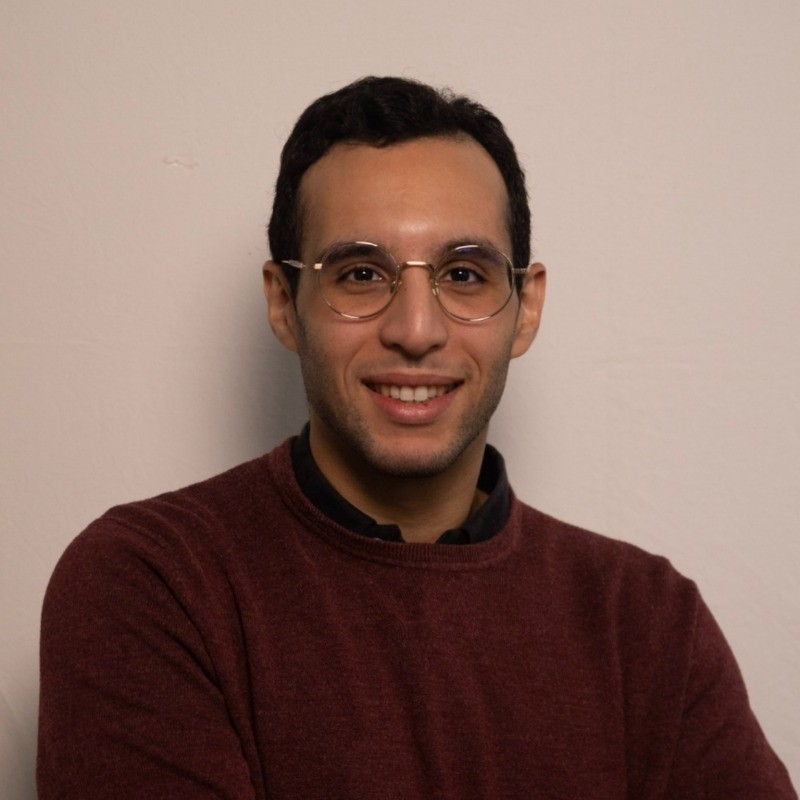
Anas Rabhi
Ingénieur IA et data scientist, fondateur de Tensoria
Depuis plus de 6 ans, je conçois et développe des systèmes IA pour le métier des entreprises. Assistants internes basés sur RAG, agents IA en production, automatisations sur mesure, traitement intelligent de documents : des produits connectés à vos processus existants, qui produisent des résultats mesurables.
À propos
Je suis ingénieur IA et data scientist, formé sur des projets variés depuis 2019 : NLP, machine learning, recherche sémantique, déploiement de modèles en production. J'ai fondé Tensoria pour me concentrer sur ce qui produit vraiment de la valeur en entreprise : transformer des problèmes métier concrets en produits IA fiables, mesurables, maintenables.
Mon angle d'attaque est toujours le même. Partir du métier, identifier les frictions réelles (saisie manuelle, recherche d'information, génération de documents, qualification), puis choisir l'outil le plus pragmatique. Souvent ce sera du RAG sur des données internes, parfois un agent IA qui orchestre plusieurs outils, parfois simplement une chaîne d'automatisation bien pensée.
Je travaille beaucoup avec des PME et ETI françaises (cabinets d'avocats, bureaux d'études, artisans BTP, courtiers en assurance, experts comptables) qui veulent intégrer l'IA sans dépendre des géants américains. Quand la confidentialité l'exige, je déploie sur des stacks souveraines (Mistral, Azure EU, infrastructures self-hosted).
Je publie régulièrement sur le blog Tensoria et sur ianas.fr les retours d'expérience de mes missions : architectures techniques, choix de stack, métriques d'évaluation, coûts réels, limites observées.
Mes domaines d'expertise
Ce sur quoi je travaille au quotidien, sur quoi je peux argumenter techniquement, et où j'ai déjà produit des résultats en production.
RAG et moteurs de recherche
Retrieval hybride (vectoriel + BM25), reranking, chunking adapté au métier, évaluation rigoureuse (recall@k, hit rate). Mistral, OpenAI, Claude, modèles self-hosted.
Agents IA
Orchestration multi-étapes, tool calling, workflows robustes pour la production. n8n, LangGraph, frameworks custom. Gestion d'erreurs et observabilité.
NLP appliqué
Classification, extraction d'entités, résumé automatique, recherche sémantique. Fine-tuning quand pertinent (CamemBERT, modèles spécialisés métier).
LLMOps
Monitoring qualité, suivi des coûts, sécurité des prompts, déploiement progressif. Eval sets construits avec les métiers, A/B testing de modèles.
Automatisations métier
Extraction emails, traitement de pièces jointes, intégrations CRM, ERP, outils SaaS. Approche pragmatique : IA quand elle apporte vraiment, code classique sinon.
IA souveraine et on-premise
Déploiement Mistral, Llama, Qwen sur infrastructure cliente ou cloud privé européen. Conformité RGPD, secret professionnel, données sensibles.
Ma façon de travailler
Quatre étapes claires, pas de promesses irréalistes, du livrable à chaque jalon.
Cadrage
1 à 2 semaines
Immersion dans le métier, identification des cas d'usage à fort impact, faisabilité technique, estimation ROI. Livrable : roadmap chiffrée.
POC fonctionnel
2 à 4 semaines
Prototype testable sur vos données réelles. Eval set construit avec vous, métriques objectives, décision Go / No Go avant d'engager la production.
Mise en production
2 à 3 mois
Intégration aux outils existants (CRM, ERP, intranet), tests, formation des utilisateurs, monitoring, déploiement progressif sur les équipes.
Maintenance et amélioration
En continu
Suivi qualité, mise à jour des modèles, ajustements selon retours utilisateurs, optimisation des coûts d'inférence.
Quelques résultats concrets
Trois exemples de gains mesurés sur des projets livrés en production.
Temps économisé
Agent IA de réponse aux appels d'offres pour un bureau d'études. ROI mesuré supérieur à 300 % sur la première année.
Temps économisé
Assistant IA déployé en usine pour la recherche dans la documentation technique. Adoption immédiate par les équipes terrain.
Plus rapide
Extraction documentaire automatisée pour un cabinet d'avocats. Réduction drastique du temps de traitement des dossiers.
Articles récents
Retours d'expérience, architectures, comparatifs et chiffres terrain.
ITAR, Diffusion Restreinte : quelle IA peut lire vos plans ?
ITAR, double usage, Diffusion Restreinte, SecNumCloud : quel hébergement pour un assistant IA selon le niveau de vos données, et ce que cela impose à l'architecture.
Annexe 22 : ce qu'un assistant IA peut faire dans un laboratoire
Annexe 22 des BPF : ce que le projet autorise pour l'IA en laboratoire pharmaceutique, usages critiques ou non, ALCOA+, GAMP 5, hébergement et relecture.
LibreChat, AnythingLLM, Onyx : quel assistant auto-hébergé ?
LibreChat, AnythingLLM, Onyx et Open WebUI comparés pour un assistant interne auto-hébergé : licence, SSO, connecteurs, droits, agents, MCP, RAG.
Fable 5.2, Opus 5.5, GPT-6 Sol, Gemini 4 Argon : lequel choisir
Fable 5.2, Opus 5.5, GPT-6 Sol ou Gemini 4 Argon ? Prix, contexte, coût par dossier, rétention des données et choix par usage, au 10 novembre 2026.
Claude Fable 5.2 : ce qui change et quel modèle choisir
Claude Fable 5.2 (9 novembre 2026) : prix en baisse à 8/40 $, Fable ou Mythos, Opus 5.5 ou Sonnet 5.5, coûts chiffrés et points de vigilance.
Changer de modèle dans un RAG ou un agent en production
Changer de modèle LLM en production : les raisons valables, la méthode en 7 étapes avec jeu de test, et ce qui casse (exemple Fable 5.2). RAG et agents.
Assistant IA pour ingénieurs du spatial : notre retour terrain
Deux générations d'assistant IA pour un grand groupe du spatial : Llama 3.1 et GraphRAG sur site, puis RAG agentique sur cloud français. Ce que nous referions.
DGX Spark en entreprise : que vaut-il pour un assistant IA ?
DGX Spark pour un assistant IA en entreprise : 128 Go de mémoire, 273 Go/s, vitesse réelle, prix en France, comparaison avec RTX PRO 6000, L40S et H100.
Claude ou Gemini : lequel choisir pour une équipe en entreprise
Claude ou Gemini pour votre équipe ? Comparatif par usage, intégrations Google et Microsoft, données, prix publics des offres et test en deux semaines.
Vous avez un projet IA ?
30 minutes de cadrage gratuit pour comprendre votre besoin et vous dire honnêtement si l'IA est le bon levier. Si oui, on discute du comment. Sinon, je vous le dis aussi.